---
title: "Байесовский вывод и сравнение моделей"
topic: bayes-inference
order: 3
description: "Теорема Байеса как правило вывода; сочетание измерений и мера их несогласия (напряжённость Хаббла); байесовский фактор, бритва Оккама и парадокс Линдли; эффекты селекции — смещение Малмквиста и наблюдательная селекция; зависимость вывода от априорного распределения при единственном наблюдении"
---
В космологии нельзя поставить эксперимент: Вселенная одна, её прошлое
доступно только через свет и реликты, а многие утверждения пособия —
о сценариях, которые никто не увидит. Вывод в таких условиях —
это взвешивание гипотез по данным, и почти всё, что пишут о параметрах
ΛCDM, о «напряжённостях» и о свидетельствах в пользу новой физики,
сформулировано на байесовском языке. Здесь собран минимум, нужный, чтобы
читать такие утверждения критически: теорема Байеса, сочетание
измерений, сравнение моделей и эффекты селекции. Сама теория
вероятностей считается известной.
## Теорема Байеса как правило вывода
Пусть модель $M$ с параметрами $\theta$ предсказывает распределение
данных $p(D\,|\,\theta, M)$.
::: {#def-bayes}
**Правдоподобие** — $\mathcal L(\theta) = p(D\,|\,\theta, M)$ как функция
$\theta$ при фиксированных данных. **Априорное распределение**
$\pi(\theta) = p(\theta\,|\,M)$ выражает знание о $\theta$ до данных.
**Апостериорное распределение**
$$
p(\theta\,|\,D, M) = \frac{\mathcal L(\theta)\,\pi(\theta)}{Z},
\qquad
Z = p(D\,|\,M) = \int \mathcal L(\theta)\,\pi(\theta)\,\dd\theta .
$$
Нормировка $Z$ — **обоснованность** (evidence, маргинальное
правдоподобие) модели: вероятность получить именно эти данные, усреднённая
по априорному распределению параметров.
:::
Теорема Байеса — тождество теории вероятностей [У]{.status}. Спорна не
она, а интерпретация вероятности как степени уверенности и выбор
$\pi(\theta)$; о практической стороне этого спора — ниже.
## Сочетание измерений и мера несогласия
Два независимых гауссовых измерения $x_1 \pm \sigma_1$ и $x_2 \pm \sigma_2$
одной величины $\mu$ при широком равномерном априорном распределении дают
гауссово апостериорное распределение. Проверим символьно, что произведение
правдоподобий — гауссиана со средним, взвешенным обратными дисперсиями:
```{python}
import math

import matplotlib.pyplot as plt
import numpy as np
import sympy as sp
from scipy import stats
from scipy.integrate import quad
from scipy.optimize import brentq

mu, x1, x2 = sp.symbols("mu x_1 x_2", real=True)
s1, s2 = sp.symbols("sigma_1 sigma_2", positive=True)
log_post = -(mu - x1)**2 / (2 * s1**2) - (mu - x2)**2 / (2 * s2**2)
w1, w2 = 1 / s1**2, 1 / s2**2
mu_hat = (w1 * x1 + w2 * x2) / (w1 + w2)
sigma_hat = 1 / sp.sqrt(w1 + w2)
# log p(μ) = −(μ − μ̂)²/(2σ̂²) + const: разность не зависит от μ
diff = sp.simplify(log_post + (mu - mu_hat)**2 / (2 * sigma_hat**2))
print("зависит ли остаток от μ:", sp.diff(diff, mu).simplify() != 0)
print("остаток =", sp.factor(diff))
```
Остаток не зависит от $\mu$ и равен $-\chi^2_{\min}/2$, где
$$
\chi^2_{\min} = \frac{(x_1 - x_2)^2}{\sigma_1^2 + \sigma_2^2}.
$$
Отсюда два вывода. Апостериорное среднее и ошибка
$\hat\mu = \sum w_i x_i/\sum w_i$, $\hat\sigma = (\sum w_i)^{-1/2}$
существуют всегда, но смысл имеют, только если измерения согласуются:
$\chi^2_{\min}$ — это и есть мера несогласия, и её надо проверять до
усреднения.
**Пример: напряжённость Хаббла.** Локальное измерение по цефеидам и
сверхновым $H_0 = 73{,}0 \pm 1{,}0$ км·с⁻¹·Мпк⁻¹ (Рисс и соавторы, 2022)
и вывод из реликтового излучения в ΛCDM $67{,}4 \pm 0{,}5$ (Planck, 2020):
```{python}
H_loc, sH_loc = 73.0, 1.0      # SH0ES (Riess et al. 2022)
H_cmb, sH_cmb = 67.4, 0.5      # Planck 2018, ΛCDM

def combine(xs, sigmas):
    """Среднее с весами 1/σ², его ошибка и χ² относительно среднего."""
    w = 1 / np.asarray(sigmas)**2
    m = np.sum(w * xs) / np.sum(w)
    return m, np.sum(w)**-0.5, np.sum(w * (np.asarray(xs) - m)**2)

H_mean, H_err, chi2_H = combine([H_loc, H_cmb], [sH_loc, sH_cmb])
tension = (H_loc - H_cmb) / math.hypot(sH_loc, sH_cmb)
p_H = stats.chi2.sf(chi2_H, df=1)
print(f"формальное среднее: {H_mean:.2f} ± {H_err:.2f}")
print(f"χ²_min = {chi2_H:.1f} при 1 степени свободы, p = {p_H:.1e}")
print(f"расхождение: {tension:.1f}σ")
```
Число $68{,}52 \pm 0{,}45$ ничего не значит: вероятность получить такое
расхождение случайно — $5{,}5\cdot10^{-7}$, т. е. по крайней мере одна из
моделей ошибок (или ΛCDM, через которую $H_0$ извлекается из реликтового
излучения) неверна [У]{.status}. Какая именно — данные в этой постановке
не говорят; это вопрос сравнения моделей (тема «Уравнения Фридмана»,
раздел о наблюдательном статусе).
## Сравнение моделей: байесовский фактор
::: {#def-bayes-factor}
**Байесовский фактор** моделей $M_0$ и $M_1$ — отношение их
обоснованностей $B_{01} = Z_0/Z_1$. Апостериорное отношение шансов
$$
\frac{p(M_0\,|\,D)}{p(M_1\,|\,D)} = B_{01}\,\frac{p(M_0)}{p(M_1)}
$$
равно байесовскому фактору, умноженному на априорное отношение шансов.
:::
Условная шкала Джеффриса в редакции Касса и Рафтери (1995): $B$ от 1 до 3 —
«не стоит упоминания», от 3 до 20 — положительное свидетельство, от 20 до
150 — сильное, больше 150 — очень сильное. Это соглашение, а не теорема.
**Бритва Оккама встроена в $Z$.** Если правдоподобие резко
сосредоточено около $\hat\theta$ с шириной $\sigma_\theta$, а априорное
распределение равномерно на интервале $\Delta\theta \gg \sigma_\theta$, то
$$
Z \approx \mathcal L(\hat\theta)\,\frac{\sqrt{2\pi}\,\sigma_\theta}{\Delta\theta} .
$$
Второй множитель — **множитель Оккама** $< 1$: модель с лишним
параметром «расплачивается» за долю априорного объёма, которую данные
исключили. Сложная модель выигрывает, только если улучшение
$\mathcal L_{\max}$ это перевешивает.
**Вложенные гауссовы модели.** Пусть измерена величина $x$ с ошибкой
$\sigma$. Модель $M_0$: $\theta = 0$ (например, $w + 1 = 0$ для тёмной
энергии). Модель $M_1$: $\theta$ свободен с априорным распределением
$\mathcal N(0, \tau^2)$. Тогда $Z_0 = \mathcal N(x; 0, \sigma^2)$,
$Z_1 = \mathcal N(x; 0, \sigma^2 + \tau^2)$:
```{python}
x, s, tau, th = sp.symbols("x sigma tau theta", positive=True)
gauss = lambda v, m, var: sp.exp(-(v - m)**2 / (2 * var)) / sp.sqrt(2 * sp.pi * var)
Z0 = gauss(x, 0, s**2)
Z1 = sp.integrate(gauss(x, th, s**2) * gauss(th, 0, tau**2), (th, -sp.oo, sp.oo))
print("Z₁ = N(x; 0, σ² + τ²):", sp.simplify(Z1 / gauss(x, 0, s**2 + tau**2)) == 1)
B01_sym = sp.simplify(Z0 / gauss(x, 0, s**2 + tau**2))
print("B₀₁ =", B01_sym)
```
В переменных $\nu = x/\sigma$ (значимость отклонения от нуля) и
$r = \tau/\sigma$ (ширина априорного распределения в единицах ошибки):
$$
B_{01} = \sqrt{1 + r^2}\,\exp\!\left(-\frac{\nu^2}{2}\,\frac{r^2}{1 + r^2}\right).
$$
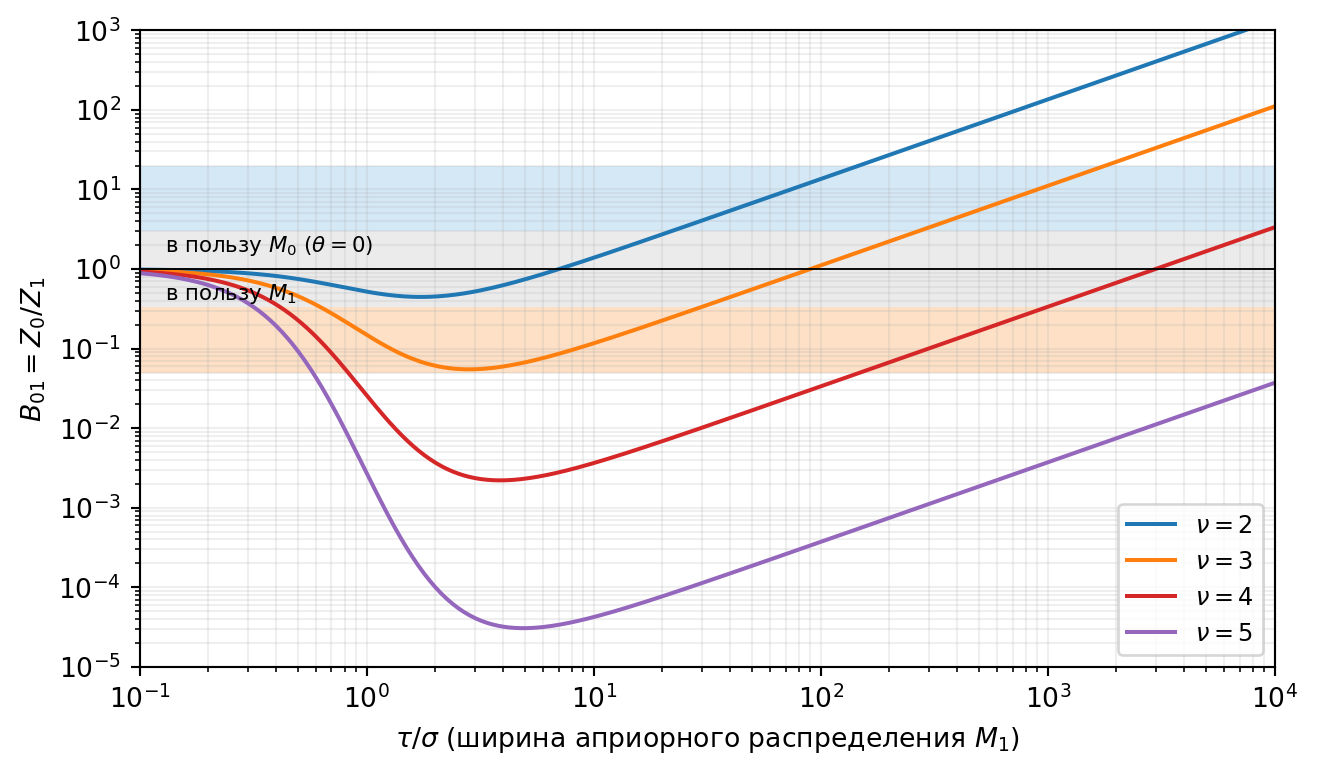
При $r \to \infty$ фактор растёт как $r\,e^{-\nu^2/2}$: при любом
фиксированном $\nu$ достаточно широкое априорное распределение делает
свидетельство в пользу простой модели сколь угодно сильным. Это
**парадокс Линдли** (1957): $p$-значение и байесовский фактор отвечают на
разные вопросы, и «3σ» само по себе не означает свидетельства против
$M_0$.
```{python}
#| label: fig-lindley
#| fig-cap: "Байесовский фактор B₀₁ в пользу модели θ = 0 для измерения, отклонившегося от нуля на ν стандартных ошибок, как функция ширины априорного распределения τ/σ альтернативной модели. Полосы — шкала Касса–Рафтери: серая — «не стоит упоминания» (1/3 < B₀₁ < 3), голубая и оранжевая — положительное свидетельство (от 3 до 20) в пользу M₀ и M₁ соответственно. Выше единицы данные свидетельствуют в пользу простой модели."
def B01(nu, r):
    return np.sqrt(1 + r**2) * np.exp(-nu**2 / 2 * r**2 / (1 + r**2))

r_grid = np.logspace(-1, 4, 400)
fig, ax = plt.subplots(figsize=(7, 4.2))
for B_lo, B_hi, c in [(1 / 3, 3, "0.92"), (1 / 20, 1 / 3, "#fde0c5"), (3, 20, "#d5e8f5")]:
    ax.axhspan(B_lo, B_hi, color=c, lw=0)
for nu, col in zip([2, 3, 4, 5], ["tab:blue", "tab:orange", "tab:red", "tab:purple"]):
    ax.loglog(r_grid, B01(nu, r_grid), color=col, label=fr"$\nu = {nu}$")
ax.axhline(1, color="k", lw=0.7)
ax.set(xlabel=r"$\tau/\sigma$ (ширина априорного распределения $M_1$)",
       ylabel=r"$B_{01} = Z_0/Z_1$", ylim=(1e-5, 1e3), xlim=(0.1, 1e4))
ax.text(0.13, 1.4, "в пользу $M_0$ ($\\theta = 0$)", fontsize=8, va="bottom")
ax.text(0.13, 0.7, "в пользу $M_1$", fontsize=8, va="top")
ax.legend(loc="lower right", fontsize=9)
ax.grid(alpha=0.2, which="both")
fig.tight_layout()

for nu in (2, 3, 4):
    r_eq = sp.nsolve(sp.log(B01_sym.subs({x: nu, s: 1, tau: sp.Symbol("r")})),
                     sp.Symbol("r"), 50 if nu > 2 else 5)
    print(f"ν = {nu}: B₀₁ = 1 при τ/σ = {float(r_eq):.0f};  "
          f"B₀₁(τ/σ = 10) = {B01(nu, 10):.3g},  B₀₁(τ/σ = 100) = {B01(nu, 100):.3g}")
print(f"двустороннее p-значение для 3σ: {2 * stats.norm.sf(3):.4f}")
```
Отклонение на $3\sigma$ ($p = 0{,}0027$) при априорной ширине в 10 ошибок
даёт $B_{01} \approx 0{,}12$, т. е. около 9:1 в пользу $M_1$; при ширине
в 100 ошибок — уже $B_{01} \approx 1{,}1$, данные ничего не решают. А отклонение
на $2\sigma$ ни при какой ширине не даёт и положительного свидетельства
против $M_0$: минимум по $r$ равен $\nu\,e^{-(\nu^2-1)/2} \approx 0{,}45$
(достигается при $r^2 = \nu^2 - 1$). Поэтому
утверждения вида «новая физика предпочтительнее на $n\sigma$» всегда надо
читать вместе с тем, какая альтернатива и с каким априорным распределением
рассматривалась (так, сообщения DESI 2025 г. о меняющейся тёмной энергии
сформулированы в терминах значимости при фиксированной
параметризации $w_0, w_a$).
## Эффекты селекции
Правдоподобие должно описывать, как данные *попали в выборку*. Если
отбор зависит от измеряемой величины, наивный вывод смещён.
**Смещение Малмквиста.** Объекты с гауссовой функцией светимости
(абсолютная звёздная величина $M$, среднее $M_0$, разброс $\sigma$)
равномерно заполняют евклидово пространство; в каталог попадают объекты
ярче видимой величины $m_{\lim}$. Среди объектов с данной видимой
величиной $m$ число находящихся на расстоянии $d$ пропорционально
$d^2\,\dd d \propto 10^{0.6(m - M)}\,\dd M$, поэтому распределение $M$ при
данном $m$ — гауссиана, умноженная на $e^{-0.6\ln 10\,M}$:
```{python}
M_, M0, sM, k = sp.symbols("M M_0 sigma_M k", real=True)
k_val = sp.Rational(3, 5) * sp.log(10)           # 0,6 ln 10
w = sp.exp(-(M_ - M0)**2 / (2 * sM**2) - k * M_)
mean_M = sp.integrate(M_ * w, (M_, -sp.oo, sp.oo), conds="none") / \
         sp.integrate(w, (M_, -sp.oo, sp.oo), conds="none")
shift = sp.simplify(mean_M - M0)
print("⟨M⟩ − M₀ =", shift, "=", f"{float(shift.subs(k, k_val) / sM**2):.4f} σ²")
```
$$
\langle M\rangle - M_0 = -0{,}6\ln 10\;\sigma^2 = -1{,}382\,\sigma^2 .
$$
Сдвиг одинаков для всех $m$, и значит, для всей выборки, ограниченной по
потоку: средний объект каталога ярче среднего объекта в пространстве.
Проверим моделированием (о методе — тема «Методы Монте-Карло и
стохастическое моделирование»):
```{python}
rng = np.random.default_rng(2026)
n_obj, sigma_M = 4_000_000, 0.5
d = 1000 * rng.random(n_obj) ** (1 / 3)        # равномерно в шаре, пк
M_abs = rng.normal(0.0, sigma_M, n_obj)
m_app = M_abs + 5 * np.log10(d / 10)           # модуль расстояния
m_lim = np.quantile(m_app, 0.05)               # каталог: 5 % самых ярких
sel = m_app < m_lim
mc_shift = M_abs[sel].mean()
print(f"в каталоге {sel.sum()} объектов; ⟨M⟩ − M₀ = {mc_shift:.3f}, "
      f"формула: {-0.6 * math.log(10) * sigma_M**2:.3f}")
```
(Порог выбран так, чтобы каталог не доставал до границы шара: иначе
пространство «кончается» и сдвиг меньше.) Смещение Малмквиста и родственные
эффекты — главная систематика шкалы внегалактических расстояний [У]{.status}
(обзор: Теерикорпи, 1997).
**Наблюдательная селекция.** Тот же вопрос — «как данные попали в
выборку» — возникает, когда наблюдатель сам является частью выборки. Мы
измеряем свойства Вселенной только там и тогда, где возможны наблюдатели;
поэтому, например, то, что мы видим Вселенную в возрасте нескольких
миллиардов лет, а не $10^{-30}$ с, не требует объяснения сверх этого
условия. Учитывать такой отбор в правдоподобии — просто корректный
вывод (Картер, 1974, назвал это слабым антропным принципом) [У]{.status}.
Выводы же о «ансамбле вселенных» требуют гипотезы о существовании и
мере ансамбля [С]{.status} (темы «Антропные рассуждения» и «Мультивселенная и проблема меры»).
## Единственное наблюдение и роль априорного распределения
Когда данных мало, ответ определяется не ими, а $\pi(\theta)$.
Характерный для этого пособия пример — вывод о частоте зарождения жизни
из того, что на Земле она возникла рано (Шпигель и Тёрнер, 2012).
Упрощённая модель: жизнь возникает как пуассоновский процесс с темпом
$\lambda$ (в единицах (млрд лет)⁻¹); на Земле она появилась в течение
$t_1$ после того, как это стало возможно. Наблюдатели появляются лишь там,
где жизнь возникла не позднее $t_{\max}$ (иначе не хватит времени на
дальнейшую эволюцию). Тогда с учётом селекции
$$
\mathcal L(\lambda) = \frac{1 - e^{-\lambda t_1}}{1 - e^{-\lambda t_{\max}}} .
$$
```{python}
t1, t_max = 0.5, 3.0                          # млрд лет: значения условны
lam_lo, lam_hi = 1e-3, 1e3                    # (млрд лет)⁻¹: границы априорного интервала

def like(lam):
    return -np.expm1(-lam * t1) / -np.expm1(-lam * t_max)

def prob_rare(prior, lam_cut=1.0):
    """P(λ < lam_cut | данные) для априорной плотности prior(λ)."""
    f = lambda lam: like(lam) * prior(lam)
    num = quad(f, lam_lo, lam_cut, limit=200)[0]
    return num / (num + quad(f, lam_cut, lam_hi, limit=200)[0])

uniform = lambda lam: 1.0
log_uniform = lambda lam: 1 / lam
print(f"L(λ → 0) = t₁/t_max = {like(1e-9):.3f};  L(λ → ∞) = {like(1e3):.3f}")
for name, prior in [("равномерное по λ", uniform), ("равномерное по ln λ", log_uniform)]:
    print(f"{name:20s}: P(λ < 1/млрд лет | D) = {prob_rare(prior):.4f}")
```
Правдоподобие меняется всего в $t_{\max}/t_1 = 6$ раз между «жизнь
редка» и «жизнь неизбежна» — данные слабые. При априорном распределении,
равномерном по $\lambda$, вероятность редкой жизни $\lambda < 1$ (млрд лет)⁻¹
ничтожна (около $3\cdot10^{-4}$), при равномерном по $\ln\lambda$ —
около 0,18: ответ задаёт выбор априорного распределения, а не наблюдение
[У]{.status}. Это не довод против байесовского подхода: он лишь делает
явной зависимость, которая в словесном рассуждении («жизнь возникла
быстро, значит, она возникает легко») скрыта.
## Физика и наблюдательный статус
- Правила байесовского вывода — математика [У]{.status}. Когда данные
сильные ($\sigma_\theta \ll$ ширины $\pi$), апостериорное распределение
от априорного почти не зависит, и байесовские и частотные доверительные
интервалы практически совпадают.
- Байесовский фактор, в отличие от апостериорного распределения
параметров, зависит от ширины априорного распределения *всегда*,
линейно при $\tau \gg \sigma$. Результаты сравнения моделей без
обоснования априорных распределений не следует принимать как
количественные.
- Интерпретация вероятности (частота или степень уверенности) — предмет
незавершённого философского спора; на практические выводы при хороших
данных он не влияет.
- Учёт селекции — обязательная часть модели данных; выводы о мире,
сделанные из выборки с неучтённой селекцией, систематически смещены.
## Итоги
- $p(\theta\,|\,D) = \mathcal L(\theta)\pi(\theta)/Z$; обоснованность $Z$
включает множитель Оккама $\approx \sqrt{2\pi}\sigma_\theta/\Delta\theta$.
- Сочетать измерения можно только после проверки согласия:
$\chi^2_{\min} = (x_1 - x_2)^2/(\sigma_1^2 + \sigma_2^2)$. Для $H_0$
(73,0 ± 1,0 и 67,4 ± 0,5) расхождение 5,0σ, $p \approx 5{,}5\cdot10^{-7}$.
- Для вложенных гауссовых моделей
$B_{01} = \sqrt{1 + r^2}\,e^{-\nu^2 r^2/2(1+r^2)}$; отклонение на 3σ
нейтрально при $\tau/\sigma \approx 90$ (парадокс Линдли).
- Выборка, ограниченная по потоку, смещена: $\Delta M = -1{,}382\,\sigma^2$
(Малмквист).
- При единственном наблюдении вывод определяется априорным распределением.
## Упражнения
1. Какую дополнительную систематическую ошибку $\sigma_{\rm sys}$ надо
добавить к локальному измерению $H_0$, чтобы $\chi^2_{\min}$ для пары
измерений стал равен 1? Каким тогда будет формальное среднее?
2. Получите множитель Оккама из точного $B_{01}$: покажите, что при
$r \gg 1$ и $\nu^2 \ll r^2$ $B_{01} \approx r\,e^{-\nu^2/2}$,
и сравните с приближением $Z \approx \mathcal L_{\max}\sqrt{2\pi}\sigma_\theta/\Delta\theta$
для равномерного априорного распределения ширины $\Delta\theta = \sqrt{2\pi}\,\tau$.
3. Отношение Сэвиджа–Дики: для вложенных моделей
$B_{01} = p(\theta = 0\,|\,D, M_1)/\pi(\theta = 0\,|\,M_1)$. Проверьте
эту формулу для гауссовой модели из текста.
4. Сверхновые Ia после стандартизации имеют разброс абсолютной величины
$\sigma_M \approx 0{,}3$. Насколько, без учёта смещения Малмквиста,
были бы занижены расстояния в выборке, ограниченной по потоку, и в какую
сторону сместилась бы оценка $H_0$?
5. В модели раннего зарождения жизни найдите $P(\lambda < 1~(\text{млрд лет})^{-1}\,|\,D)$
при $t_1 = 0{,}1$ млрд лет (жизнь появилась ещё быстрее) для обоих
априорных распределений. Почему результат для логарифмически
равномерного распределения изменился мало?
::: {.callout-tip collapse="true"}
## Ответы
1. $\sigma_{\rm sys} = \sqrt{(x_1 - x_2)^2 - \sigma_1^2 - \sigma_2^2} = 5{,}5$
км·с⁻¹·Мпк⁻¹, т. е. ошибку локального измерения пришлось бы увеличить
в 5,6 раза. Среднее тогда $67{,}4 \pm 0{,}5$: оно почти целиком задаётся
реликтовым излучением.
2. При $r \gg 1$: $\sqrt{1+r^2} \to r$, $r^2/(1+r^2) \to 1$. С другой
стороны, $\mathcal L_{\max}/Z_0 = e^{\nu^2/2}$, а
$Z_1 \approx \mathcal L_{\max}\sqrt{2\pi}\sigma/(\sqrt{2\pi}\tau)$, так
что $B_{01} = Z_0/Z_1 \approx (\tau/\sigma)e^{-\nu^2/2}$ — совпадает.
Множитель Оккама — это $\sigma/\tau = 1/r$.
3. Апостериорное распределение $\theta$ в $M_1$ — гауссиана со средним
$x\tau^2/(\sigma^2 + \tau^2)$ и дисперсией $\sigma^2\tau^2/(\sigma^2 + \tau^2)$;
её значение в нуле, делённое на $\mathcal N(0; 0, \tau^2)$, тождественно
равно $B_{01}$ (проверено SymPy в скрытой ячейке).
4. $\Delta M = -1{,}382\cdot0{,}09 = -0{,}124$: объекты выборки в среднем
ярче, и если приписать им $M_0$, расстояния будут занижены в
$10^{0{,}2\cdot0{,}124} = 1{,}059$ раза, т. е. на 6 %; $H_0 = v/d$ —
завышена на 6 %. (В реальных калибровках смещение учитывают
моделированием отбора.)
5. Правдоподобие при $\lambda \to 0$ стремится к $t_1/t_{\max} = 1/30$
вместо $1/6$. Для равномерного по $\lambda$ распределения
$P \approx 6\cdot10^{-5}$, для равномерного по $\ln\lambda$ — 0,054
(было $3\cdot10^{-4}$ и 0,18). При логарифмически равномерном распределении
большая часть априорной массы лежит при $\lambda \gg 1$, где
правдоподобие близко к 1 при любом $t_1$, а область $\lambda \ll 1$
подавлена лишь на множитель $t_1/t_{\max}$; утверждение «жизнь
возникает легко» остаётся зависимым от априорного выбора.
:::
## Литература
- Jaynes E. T. *Probability Theory: The Logic of Science.* — Cambridge
University Press, 2003.
- Kass R. E., Raftery A. E. Bayes factors. *J. Am. Stat. Assoc.* **90**,
773 (1995).
- Lindley D. V. A statistical paradox. *Biometrika* **44**, 187 (1957).
- Trotta R. Bayes in the sky: Bayesian inference and model selection in
cosmology. *Contemp. Phys.* **49**, 71 (2008), arXiv:0803.4089.
- Teerikorpi P. Observational selection bias affecting the determination
of the extragalactic distance scale. *Annu. Rev. Astron. Astrophys.*
**35**, 101 (1997).
- Carter B. Large number coincidences and the anthropic principle in
cosmology. In: *Confrontation of Cosmological Theories with
Observational Data* (IAU Symp. 63), ed. M. S. Longair. — Dordrecht:
Reidel, 1974. P. 291.
- Spiegel D. S., Turner E. L. Bayesian analysis of the astrobiological
implications of life's early emergence on Earth. *Proc. Natl. Acad.
Sci. USA* **109**, 395 (2012), arXiv:1107.3835.
- Riess A. G. et al. A comprehensive measurement of the local value of the
Hubble constant with 1 km/s/Mpc uncertainty from the Hubble Space
Telescope and the SH0ES team. *Astrophys. J. Lett.* **934**, L7 (2022),
arXiv:2112.04510.
- Planck Collaboration. Planck 2018 results. VI. Cosmological parameters.
*Astron. Astrophys.* **641**, A6 (2020), arXiv:1807.06209.
```{python}
#| echo: false
#| output: false
# Проверка формул и ответов (не показывается на странице)
# сочетание измерений
assert sp.simplify(diff + (x1 - x2)**2 / (2 * (s1**2 + s2**2))) == 0
assert round(H_mean, 2) == 68.52 and round(H_err, 2) == 0.45
assert round(tension, 1) == 5.0 and round(p_H, 8) == 5.5e-7
# байесовский фактор
B_check = sp.sqrt(1 + tau**2 / s**2) * sp.exp(-x**2 / (2 * s**2) * tau**2 / (s**2 + tau**2))
assert sp.simplify(B01_sym - B_check) == 0
assert round(B01(3, 10), 2) == 0.12 and round(B01(3, 100), 1) == 1.1
assert round(1 / B01(3, 10)) == 9
r3 = brentq(lambda r: B01(3, r) - 1, 10, 1e3)
assert round(r3, -1) == 90
assert round(2 * math.exp(-1.5), 2) == 0.45 and abs(B01(2, math.sqrt(3)) - 2 * math.exp(-1.5)) < 1e-12
assert min(B01(2, r_grid)) >= 2 * math.exp(-1.5)
assert round(2 * stats.norm.sf(3), 4) == 0.0027
# Малмквист
assert sp.simplify(shift + k * sM**2) == 0
assert round(float(k_val) , 3) == 1.382
assert abs(mc_shift - (-0.6 * math.log(10) * sigma_M**2)) < 0.01
# ранняя жизнь
assert round(prob_rare(uniform), 4) == 0.0003 and round(prob_rare(log_uniform), 2) == 0.18
# 1
s_sys = math.sqrt((H_loc - H_cmb)**2 - sH_loc**2 - sH_cmb**2)
assert round(s_sys, 1) == 5.5 and round(math.hypot(sH_loc, s_sys) / sH_loc, 1) == 5.6
m1, e1, c1 = combine([H_loc, H_cmb], [math.hypot(sH_loc, s_sys), sH_cmb])
assert math.isclose(c1, 1, rel_tol=1e-9) and round(m1, 1) == 67.4 and round(e1, 1) == 0.5
# 2
rr = sp.Symbol("r", positive=True)
B_r = sp.sqrt(1 + rr**2) * sp.exp(-sp.Symbol("nu")**2 / 2 * rr**2 / (1 + rr**2))
assert sp.limit(B_r / (rr * sp.exp(-sp.Symbol("nu")**2 / 2)), rr, sp.oo) == 1
# 3: Сэвидж–Дики
post_var = s**2 * tau**2 / (s**2 + tau**2)
post_mean = x * tau**2 / (s**2 + tau**2)
sd = gauss(0, post_mean, post_var) / gauss(0, 0, tau**2)
assert sp.simplify(sd - B01_sym) == 0
# 4
dM = -0.6 * math.log(10) * 0.3**2
assert round(dM, 3) == -0.124 and round(10 ** (-0.2 * dM), 3) == 1.059
# 5
t1 = 0.1
assert abs(like(1e-9) - 1 / 30) < 1e-6
p5u, p5l = prob_rare(uniform), prob_rare(log_uniform)
assert round(p5u, 5) == 0.00006 and round(p5l, 3) == 0.054
t1 = 0.5
```