---
title: "Что считать установленным"
topic: epistemic-status
order: 3
description: "Критерии меток У, Г, С; доказательство без эксперимента — независимые линии и рискованные предсказания; предел проверяемости одной Вселенной (космическая дисперсия); типичные ошибки «больших нарративов»: апостериорная значимость, конъюнкция, экстраполяция трендов, неопровержимость"
---
Каждое содержательное утверждение пособия помечено: установлено
[У]{.status}, гипотеза [Г]{.status} или спекуляция [С]{.status}. Здесь
объясняется, на чём основана такая разметка, почему в науке о
единственной Вселенной, где нельзя поставить контрольный эксперимент,
вообще можно что-то считать установленным, и какие ошибки рассуждения
чаще всего превращают гипотезу в «факт» в популярных рассказах о
космической эволюции. Аппарат — байесовский вывод (тема «Байесовский
вывод и сравнение моделей»); здесь он применяется к вопросу о статусе.
## Три метки как решения
Метки — не степени уверенности автора, а ответы на два вопроса о
утверждении: *есть ли у него проверенные следствия* и *можно ли их
проверить хотя бы в принципе*.
::: {#def-established}
Утверждение **установлено**, если выполнено хотя бы одно из условий,
и ему не противоречат известные данные:
1. оно следует из теории, проверенной в той же области параметров
(энергий, плотностей, масштабов), без дополнительных допущений;
2. его подтверждают несколько *независимых* линий данных, то есть
данных, систематические ошибки которых не связаны;
3. оно было предсказано *до* наблюдения и выдержало проверку, которая
могла его опровергнуть.
:::
::: {#def-hypothesis}
**Гипотеза** — утверждение, из которого следуют наблюдаемые последствия,
отличающие его от альтернатив, но эти последствия пока не наблюдались
или наблюдались с недостаточной значимостью. **Спекуляция** —
утверждение, согласное с известной физикой, но без наблюдаемых
последствий, доступных сегодня или в обозримой перспективе.
:::
Граница между гипотезой и спекуляцией проходит по проверяемости, а не
по правдоподобию: распад протона [Г]{.status} маловероятен на
доступных временах, но его ищут; «другие вселенные мультивселенной»
[С]{.status} могут быть вполне естественным следствием теории, но
ни одного их наблюдаемого следствия сегодня не предложено общепринятым
образом. Спекуляция — законный предмет мысленного эксперимента, но не
довод (Эллис и Силк, 2014).
Две оговорки. Во-первых, «установлено» не значит «окончательно»:
ньютоновская гравитация установлена в своей области и остаётся
установленной после ОТО. Во-вторых, метка относится к утверждению, а не к
модели: «ΛCDM описывает реликтовое излучение» — [У]{.status}, «тёмная
энергия — космологическая постоянная» — [Г]{.status} (страница
[Конвенции](/conventions.qmd)).
## Доказательство без эксперимента
Астрофизика и космология заменяют контролируемый эксперимент тремя
приёмами.
**Естественный эксперимент.** Природа сама «варьирует параметры»: звёзды
разной массы и металличности, галактики на разных красных смещениях,
скопления разного возраста. Мы не можем зажечь звезду, но видим их
миллиарды на всех стадиях.
**Независимые линии.** Если два вывода опираются на разную физику и
разные инструменты, их байесовские свидетельства перемножаются, а
совпадение случайных ошибок маловероятно. Пример [У]{.status}: возраст
Вселенной в ΛCDM по реликтовому излучению (13,8 млрд лет) не меньше
возраста старейших звёзд (около 12–13 млрд лет), определяемого по теории
звёздной эволюции, — а модель без тёмной энергии с той же $H_0$ этот тест
провалила бы (тема «Уравнения Фридмана», упражнение 1).
**Рискованное предсказание.** Сильнее всего свидетельствует результат,
который теория могла бы и не получить. На языке байесовского фактора: если
теория $T$ заранее сосредоточила вероятность исхода в узком интервале, а
альтернатива «размазала» её по широкому, то при попадании
$B \approx (\text{ширина у альтернативы})/(\text{ширина у } T)$.
Сравним по этому критерию два знаменитых предсказания горячей Вселенной.
Альфер и Герман (1948) оценили температуру реликтового излучения
сегодня примерно в 5 К; позже измеренная 2,7 К попала в «правильный
порядок». А форму спектра — планковскую — теория горячей Вселенной
предсказывает точно, и спектрометр FIRAS на COBE не нашёл отклонений
на уровне $|\mu| < 9\cdot10^{-5}$, $|y| < 1{,}5\cdot10^{-5}$
(Фиксен и соавторы, 1996):
```{python}
import math

import matplotlib.pyplot as plt
import numpy as np
from scipy import stats
from scipy.optimize import curve_fit

def bayes_factor_log(width_alt, width_theory):
    """B для логарифмически равномерных предсказаний: отношение ширин по ln."""
    return math.log(width_alt) / math.log(width_theory)

# альтернатива: T₀ где угодно от 10⁻³ до 10³ К; теория: «от 1 до 10 К»
B_order = bayes_factor_log(1e6, 10)
# точное предсказание формы: μ-искажение в пределах ±10⁻⁴ при альтернативе,
# допускающей искажения порядка единицы (равномерно на [−1, 1])
B_shape = 2 / 2e-4
print(f"предсказание по порядку величины: B ≈ {B_order:.0f}")
print(f"предсказание формы спектра:       B ≈ {B_shape:.0e}")
```
Оценка «по порядку величины» даёт свидетельство всего около 6:1, а
планковская форма спектра — порядка $10^4$, причём это ещё грубая
нижняя оценка (FIRAS проверил не одно число, а сотни частот). Поэтому
горячая модель установлена не «потому что предсказала реликтовое
излучение», а потому что предсказала *его спектр* (тема «Горячая
Вселенная — наблюдательные основания»).
## Предел проверяемости: одна Вселенная
У космологии есть ограничение, которого нет у лабораторной физики:
выборка конечна в принципе. Угловое распределение температуры
реликтового излучения раскладывается по сферическим гармоникам; на
мультиполе $\ell$ независимых коэффициентов $a_{\ell m}$ всего $2\ell + 1$.
Если они гауссовы с дисперсией $C_\ell$, оценка
$\hat C_\ell = \sum_m |a_{\ell m}|^2/(2\ell + 1)$ распределена как
$C_\ell\chi^2_{2\ell+1}/(2\ell+1)$, и её относительная ошибка —
**космическая дисперсия**
$$
\frac{\Delta C_\ell}{C_\ell} = \sqrt{\frac{2}{2\ell + 1}} .
$$
```{python}
def cosmic_variance(ell):
    return np.sqrt(2 / (2 * ell + 1))

rng = np.random.default_rng(1)
for ell in (2, 10, 100):
    # моделирование: 2ℓ+1 гауссовых коэффициентов с единичной дисперсией
    # (для простоты вещественных), 200 000 «вселенных»
    a = rng.standard_normal((200_000, 2 * ell + 1))
    C_hat = (a**2).mean(axis=1)
    print(f"ℓ = {ell:3d}: формула {cosmic_variance(ell):.3f}, моделирование {C_hat.std():.3f}")

ell_max = 2500
n_modes = sum(2 * l + 1 for l in range(2, ell_max + 1))
print(f"число независимых мод температуры до ℓ = {ell_max}: {n_modes:.2e}")
```
На квадруполе ($\ell = 2$) ошибка 63 %, и её нельзя уменьшить никаким
инструментом: у нас одно небо. Всё, что реликтовое излучение говорит о
температурных флуктуациях, сосредоточено примерно в $6\cdot10^6$ числах
(без учёта поляризации и линзирования). Отсюда принципиальная
осторожность: утверждения о самых больших масштабах (например, о
природе «аномалий» на низких мультиполях) статистически ограничены
навсегда [У]{.status}, а утверждения о том, что лежит за горизонтом,
проверить нельзя вовсе (тема «Расстояния и горизонты»).
## Типичные ошибки больших нарративов
Рассказ о космической эволюции — длинная цепочка от Большого взрыва к
разуму. Такие рассказы уязвимы для нескольких ошибок, которые
выглядят как доводы.
**1. Апостериорная значимость.** Если аномалию выбрали *после* того,
как посмотрели на данные, локальная значимость обманывает: среди многих
возможных проверок какая-то случайно окажется «значимой» (эффект
«поиска в другом месте», look-elsewhere; Гросс и Виттелс, 2010).
Для $N$ независимых проверок
$$
p_{\rm глоб} = 1 - (1 - p_{\rm лок})^N .
$$
```{python}
p3 = 2 * stats.norm.sf(3)                       # двусторонний уровень 3σ
for N in (1, 10, 50, 200):
    p_glob = 1 - (1 - p3)**N
    print(f"N = {N:3d}: P(хотя бы одна «аномалия» ≥ 3σ) = {p_glob:.3f}")
```
Из 50 независимых проверок случайного неба хотя бы одна даст «3σ» с
вероятностью 13 %. Сообщение «найдена аномалия на уровне $3\sigma$»
без учёта числа просмотренных вариантов почти ничего не значит; поэтому
крупномасштабные аномалии реликтового излучения (Planck, 2020, VII)
остаются обсуждаемыми, но не установленными [Г]{.status}.
**2. Конъюнкция.** Длинная цепочка правдоподобных шагов кажется
убедительнее одного шага, хотя вероятность цепочки — произведение
вероятностей шагов (при их независимости) и только убывает. Психологи
описали это как «ошибку конъюнкции» (Тверски и Канеман, 1983): подробный
сценарий кажется вероятнее, чем любая его часть.
```{python}
for p_step in (0.95, 0.9, 0.8):
    n_half = math.ceil(math.log(0.5) / math.log(p_step))
    print(f"шаг {p_step}: 10 шагов — {p_step**10:.2f}; ниже 1/2 начиная с {n_half} шагов")
```
Десять шагов по 90 % — это 35 % для всей цепочки. Сценарии далёкого
будущего разума (раздел «Разум в далёком будущем») состоят из десятков
шагов; поэтому они спекуляции [С]{.status} даже тогда, когда каждый шаг
по отдельности выглядит разумно.
**3. Экстраполяция тренда.** Утверждения «сложность растёт
экспоненциально» или «удельная мощность растёт со временем» строятся по
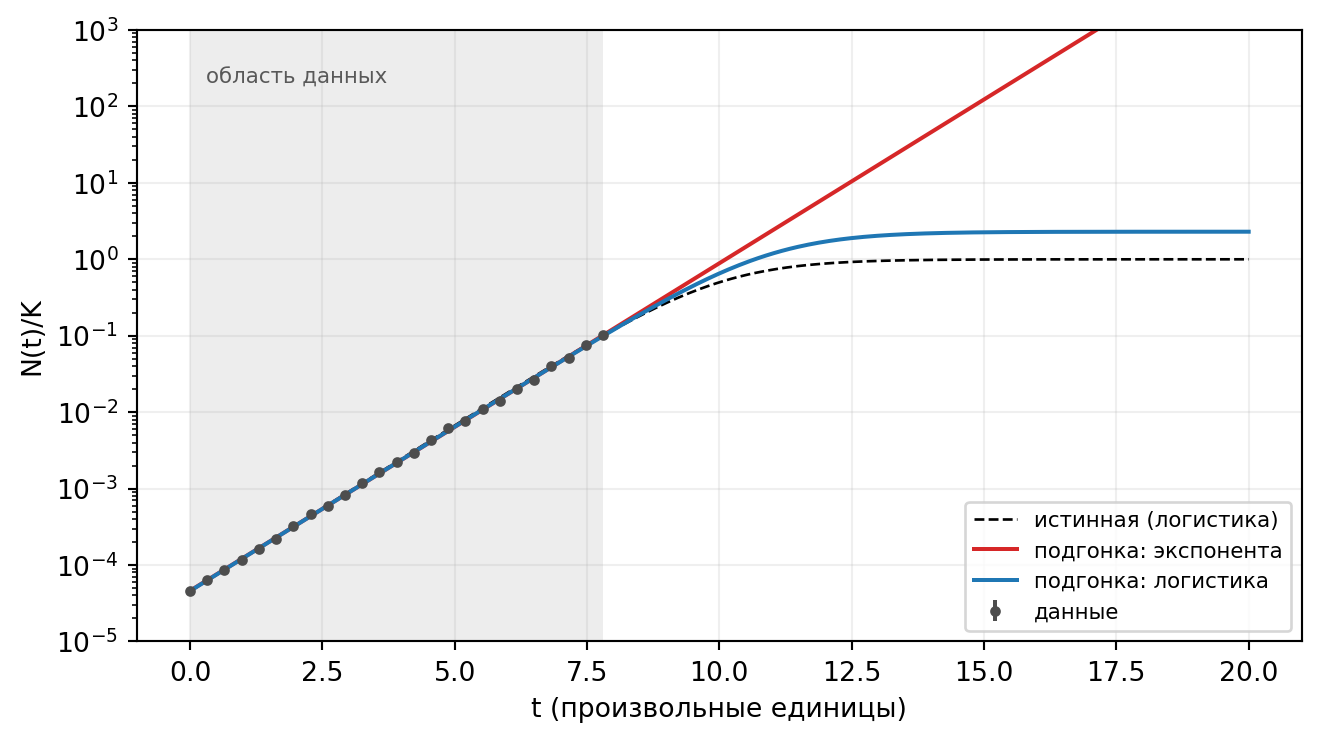
отрезку истории. Но на начальном участке логистическая кривая
$N(t) = K/[1 + e^{-r(t - t_*)}]$ неотличима от экспоненты: при
$t \ll t_*$ относительное различие порядка $N/K$. Смоделируем данные с
шумом 5 % на начальном участке логистики и подгоним обе модели:
```{python}
#| label: fig-extrapolation
#| fig-cap: "Экстраполяция тренда. Точки — «данные» с шумом 5 %, взятые с начального участка логистической кривой (до 10 % насыщения). Экспонента и логистика (с подобранными параметрами) описывают их одинаково хорошо, но расходятся на порядки при экстраполяции. Штриховая — истинная кривая."
K_true, r_true, t_star = 1.0, 1.0, 10.0

def logistic(t, K, r, ts):
    return K / (1 + np.exp(-r * (t - ts)))

def exponential(t, A, r):
    return A * np.exp(r * t)

t_data = np.linspace(0, t_star - math.log(9), 25)      # до N/K = 0,1
rng = np.random.default_rng(7)
y_data = logistic(t_data, K_true, r_true, t_star) * (1 + 0.05 * rng.standard_normal(t_data.size))
sigma = 0.05 * y_data

p_exp, _ = curve_fit(exponential, t_data, y_data, p0=[1e-4, 1], sigma=sigma)
p_log, _ = curve_fit(logistic, t_data, y_data, p0=[1, 1, 10], sigma=sigma, maxfev=20000)
chi2 = lambda f, p: np.sum(((y_data - f(t_data, *p)) / sigma)**2)
chi2_exp, chi2_log = chi2(exponential, p_exp), chi2(logistic, p_log)
print(f"χ²: экспонента {chi2_exp:.1f} (23 ст. св.), логистика {chi2_log:.1f} (22 ст. св.)")
print(f"подобранная K логистики: {p_log[0]:.2f} (истинная {K_true})")
t_far = 2 * t_star
print(f"при t = {t_far:.0f}: истина {logistic(t_far, K_true, r_true, t_star):.2f}, "
      f"экспонента {exponential(t_far, *p_exp):.0f}, логистика {logistic(t_far, *p_log):.2f}")

tt = np.linspace(0, 2 * t_star, 400)
fig, ax = plt.subplots(figsize=(7, 4))
ax.semilogy(tt, logistic(tt, K_true, r_true, t_star), "k--", lw=1, label="истинная (логистика)")
ax.semilogy(tt, exponential(tt, *p_exp), color="tab:red", label="подгонка: экспонента")
ax.semilogy(tt, logistic(tt, *p_log), color="tab:blue", label="подгонка: логистика")
ax.errorbar(t_data, y_data, yerr=sigma, fmt="o", ms=3, color="0.3", label="данные")
ax.axvspan(0, t_data[-1], color="0.93", lw=0)
ax.text(0.3, 2e2, "область данных", fontsize=8, color="0.35")
ax.set(xlabel="t (произвольные единицы)", ylabel="N(t)/K", ylim=(1e-5, 1e3))
ax.legend(loc="lower right", fontsize=8)
ax.grid(alpha=0.2)
fig.tight_layout()
```
Обе модели описывают данные (значения $\chi^2$ почти равны и близки
к числу степеней свободы), а предсказания при $t = 2t_*$ расходятся на
четыре порядка. Даже подгонка *правильной* (логистической) моделью
ошибается в уровне насыщения $K$ более чем вдвое: на начальном участке
$K$ почти не влияет на кривую. Данные с начального
участка тренда не говорят ничего о том, где он остановится; утверждение
о продолжении роста — гипотеза о механизме, а не следствие данных
[У]{.status}. Это прямо касается «кривой Чейссона» (тема «Удельная
мощность как мера сложности») и рассуждений о технологической
«сингулярности».
**4. Неопровержимость.** Объяснение, совместимое с любым исходом, не
сосредотачивает вероятность ни на одном и потому, по байесовскому
фактору, проигрывает любой теории, сделавшей верное предсказание.
«Всё развивается к большей сложности» без указания, *что* именно и
*когда* должно наблюдаться, — не закон, а описание [Г]{.status} (тема
«Растёт ли сложность Вселенной?»).
**5. Отбор примеров и селекция.** Последовательность «частицы → атомы →
звёзды → жизнь → разум» составлена из систем, которые *мы* выбрали как
вехи, и наблюдается из единственной точки, где разум возник. Без учёта
этого отбора (тема «Байесовский вывод и сравнение моделей», раздел об
эффектах селекции) любая последовательность выглядит направленной.
**6. Телеология и подмена статуса.** «Материя стремится к усложнению»,
«Вселенная создала наблюдателя, чтобы познать себя» — это не гипотезы о
механизме, а метафоры. В пособии они допустимы только как разбираемые
цитаты (тема «Что такое космическая эволюция»). Родственная ошибка —
переход от «модель описывает» к «природа такова» без новой проверки.
## Как метки ставятся в пособии
Решение для отдельного утверждения принимается по схеме:
1. Следует ли утверждение из проверенной теории в её области
применимости или подтверждено независимыми линиями данных? — [У]{.status}.
Если следствие прямо не наблюдалось (излучение Хокинга), это
оговаривается в тексте.
2. Иначе: есть ли наблюдение, которое могло бы его опровергнуть, и
выполнимо ли оно сейчас или в обозримом будущем? — [Г]{.status}.
3. Иначе — [С]{.status}.
Количественные утверждения при этом сопровождаются источником и
погрешностью; свежие данные — датой («по данным на 2025 г.»), потому
что статус гипотез меняется. Если в ходе работы над пособием статус
утверждения изменится (например, подтвердится эволюция тёмной энергии,
тема «Меняется ли тёмная энергия?»), меняется метка, а не формулировка
задним числом.
## Итоги
- [У]{.status} — следует из проверенной теории в её области или
подтверждено независимыми линиями, в том числе рискованными
предсказаниями; [Г]{.status} — есть доступная проверка, но нет
подтверждения; [С]{.status} — нет доступных проверок.
- Сила свидетельства измеряется тем, насколько узко теория заранее
ограничила исход: «правильный порядок» даёт множитель около 6,
точная форма спектра — порядка $10^4$ и больше.
- Одна Вселенная — конечная выборка: $\Delta C_\ell/C_\ell = \sqrt{2/(2\ell+1)}$,
63 % на квадруполе.
- Ошибки нарративов: апостериорная значимость
($p_{\rm глоб} = 1 - (1-p)^N$), конъюнкция (вероятность цепочки —
произведение), экстраполяция тренда (логистика неотличима от
экспоненты до насыщения), неопровержимость, неучтённая селекция,
телеология.
## Упражнения
1. Сколько мультиполей, начиная с $\ell = 2$, нужно усреднить, чтобы
космическая дисперсия средней по полосе мощности (при плоском спектре
$C_\ell$, т. е. одинаковых $C_\ell$ в полосе) стала меньше 1 %?
2. Аномалия найдена на локальном уровне $3\sigma$ среди $N = 20$
рассмотренных возможностей. Какой глобальной значимости (в σ) это
соответствует? Какой локальный уровень нужен, чтобы глобальная
значимость была $3\sigma$?
3. Сценарий состоит из шагов с вероятностью 0,95 каждый. Начиная с
какого числа шагов он менее вероятен, чем его отрицание?
4. Покажите, что при $t \ll t_*$ логистика
$K/[1 + e^{-r(t - t_*)}] = A e^{rt}[1 - N/K + O((N/K)^2)]$ и,
следовательно, при шуме $\varepsilon$ отличить её от экспоненты можно
лишь после того, как $N/K$ превысит примерно $\varepsilon$.
5. Пусть теория предсказывает $T_0$ с относительной точностью 1 %
(интервал $[0{,}99\,T, 1{,}01\,T]$), а альтернатива — логарифмически
равномерно в интервале от $10^{-3}$ до $10^3$ К. Какой байесовский
фактор даёт попадание? Сравните с предсказанием «от 1 до 10 К».
::: {.callout-tip collapse="true"}
## Ответы
1. Для полосы $\ell = 2,\dots,\ell_{\max}$ ошибка средней —
$\sqrt{2/\sum(2\ell+1)} = \sqrt{2/[(\ell_{\max}+1)^2 - 4]}$; она меньше
1 % при $\ell_{\max} \ge 141$, т. е. нужно 140 мультиполей.
2. $p_{\rm глоб} = 1 - (1 - 0{,}0027)^{20} = 0{,}053$ — около $1{,}9\sigma$.
Чтобы глобальная значимость была $3\sigma$, нужен локальный уровень
$p = 1{,}35\cdot10^{-4}$, т. е. $3{,}8\sigma$.
3. $0{,}95^{n} < 1/2$ при $n \ge 14$ ($0{,}95^{13} = 0{,}513$,
$0{,}95^{14} = 0{,}488$).
4. $K/(1 + e^{-x}) = Ke^{x}/(1 + e^{x}) = Ke^{x}(1 - e^{x} + \dots)$, и
$e^{x} = N/K + O((N/K)^2)$. Различие с экспонентой — относительная
поправка $N/K$; на фоне шума $\varepsilon$ она заметна лишь при
$N/K \gtrsim \varepsilon$ (в примере текста данные заканчиваются при
$N/K = 0{,}1$, и при шуме 5 % на отдельных точках модели почти
неразличимы).
5. $B = \ln(10^6)/\ln(1{,}01/0{,}99) = 690$ против 6 у предсказания
«по порядку». Точность предсказания, а не его «правильность»,
определяет силу свидетельства.
:::
## Литература
- Popper K. *The Logic of Scientific Discovery.* — London: Hutchinson,
1959 (нем. оригинал: *Logik der Forschung*, 1934).
- Ellis G. F. R. Issues in the philosophy of cosmology. arXiv:astro-ph/0602280
(2006).
- Ellis G., Silk J. Scientific method: Defend the integrity of physics.
*Nature* **516**, 321 (2014).
- Alpher R. A., Herman R. Evolution of the Universe. *Nature* **162**, 774
(1948).
- Fixsen D. J. et al. The cosmic microwave background spectrum from the
full COBE FIRAS data set. *Astrophys. J.* **473**, 576 (1996).
- Planck Collaboration. Planck 2018 results. VII. Isotropy and statistics
of the CMB. *Astron. Astrophys.* **641**, A7 (2020), arXiv:1906.02552.
- Gross E., Vitells O. Trial factors for the look elsewhere effect in
high energy physics. *Eur. Phys. J. C* **70**, 525 (2010).
- Tversky A., Kahneman D. Extensional versus intuitive reasoning: the
conjunction fallacy in probability judgment. *Psychol. Rev.* **90**, 293
(1983).
- Trotta R. Bayes in the sky: Bayesian inference and model selection in
cosmology. *Contemp. Phys.* **49**, 71 (2008), arXiv:0803.4089.
```{python}
#| echo: false
#| output: false
# Проверка чисел и ответов (не показывается на странице)
assert round(B_order) == 6 and B_shape == 1e4
assert round(cosmic_variance(2), 2) == 0.63
assert round(n_modes / 1e6) == 6
assert round(1 - (1 - p3)**50, 2) == 0.13
assert round(0.9**10, 2) == 0.35
assert abs(chi2_exp - chi2_log) < 2 and chi2_exp < 23
assert round(math.log10(exponential(t_far, *p_exp) / logistic(t_far, *p_log))) == 4
assert p_log[0] / K_true > 2
# 1
lmax = next(l for l in range(2, 1000) if math.sqrt(2 / ((l + 1)**2 - 4)) < 0.01)
assert lmax == 141
# 2
pg = 1 - (1 - p3)**20
assert round(pg, 3) == 0.053 and round(stats.norm.isf(pg / 2), 1) == 1.9
p_loc = 1 - (1 - p3)**(1 / 20)
assert round(p_loc * 1e4, 2) == 1.35 and round(stats.norm.isf(p_loc / 2), 1) == 3.8
# 3
assert round(0.95**13, 3) == 0.513 and round(0.95**14, 3) == 0.488
# 5
assert round(math.log(1e6) / math.log(1.01 / 0.99), -1) == 690
```